Kaeso im Benchmark von LiteLLM
Wir haben ai-gateway-bench, den Benchmark von BerriAI, der Firma hinter LiteLLM, mit Kaeso 0.7.0 neben LiteLLM, Bifrost und Portkey laufen lassen. Das sind die Zahlen und die Belege hinter jeder einzelnen.
- Veröffentlicht
- Lesezeit
- 3 Min.
BerriAI, die Firma hinter LiteLLM, veröffentlicht ai-gateway-bench (öffnet in einem neuen Tab), um zu messen, was ein AI-Gateway zur Zeit des Modellanbieters hinzufügt. Wir haben seinen lokalen Lauf mit Kaeso 0.7.0 neben jedem Gateway ausgeführt, das er vergleicht: LiteLLM Rust, LiteLLM Python, Bifrost und Portkey. Jedes lief in seiner neuesten Version auf einer Maschine, mit dem Mock-Anbieter und den Treibern des Benchmarks selbst, unverändert.
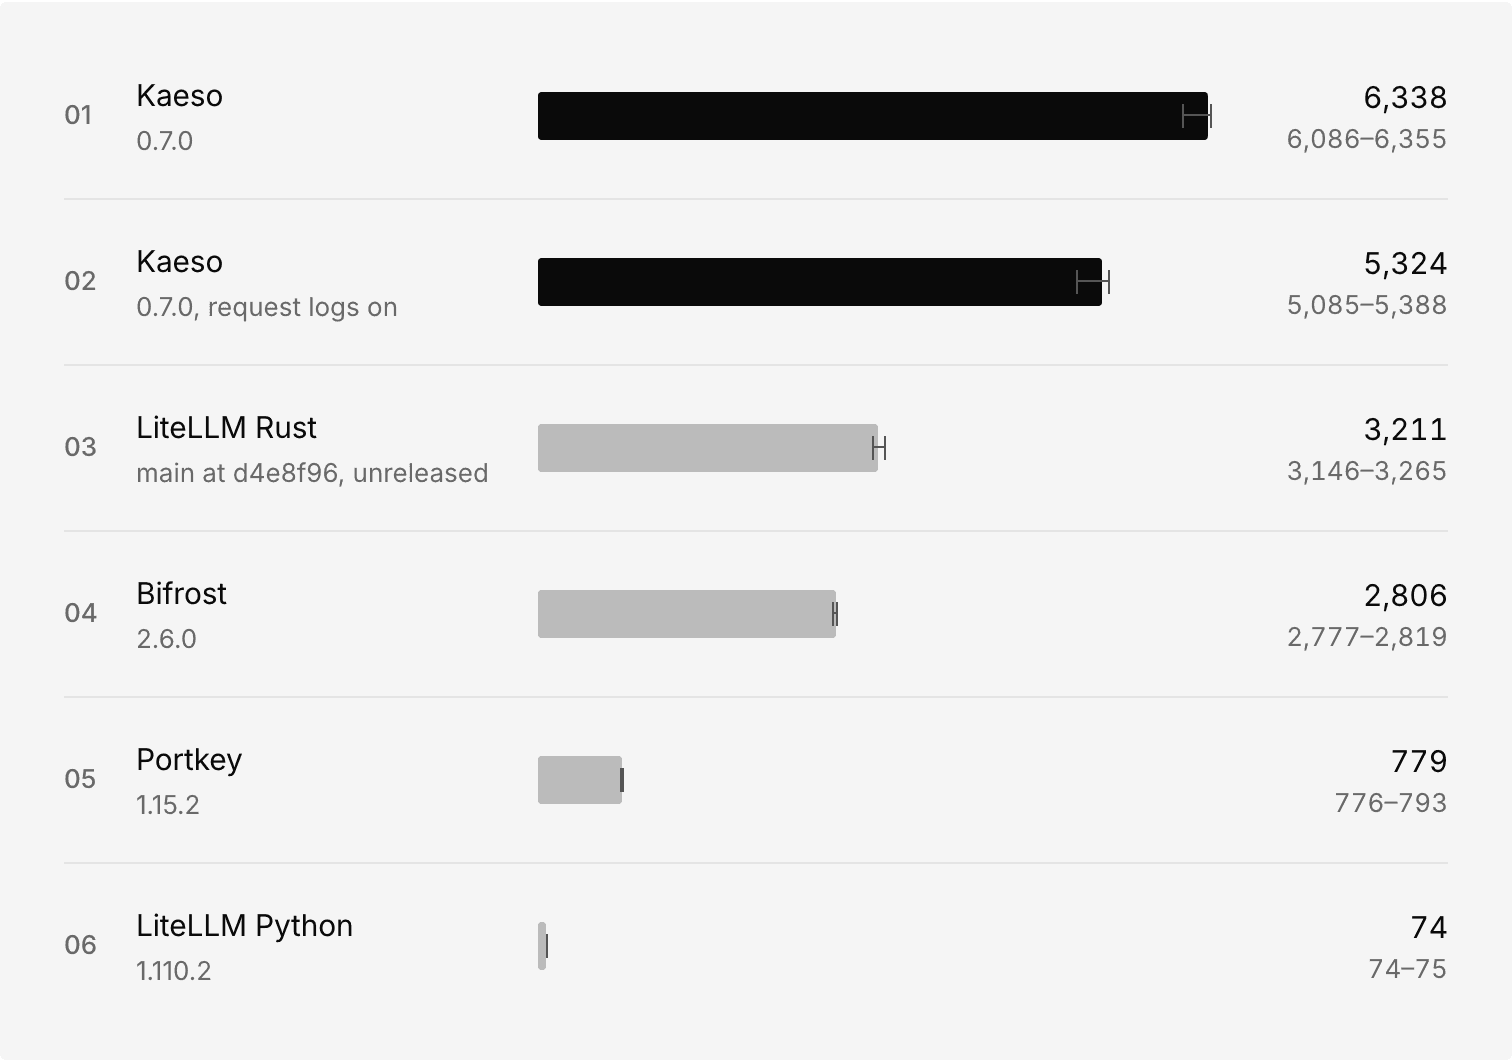
Auf denselben zwei Kernen schaffte Kaeso 6.338 Anfragen pro Sekunde und LiteLLM Rust 3.211.
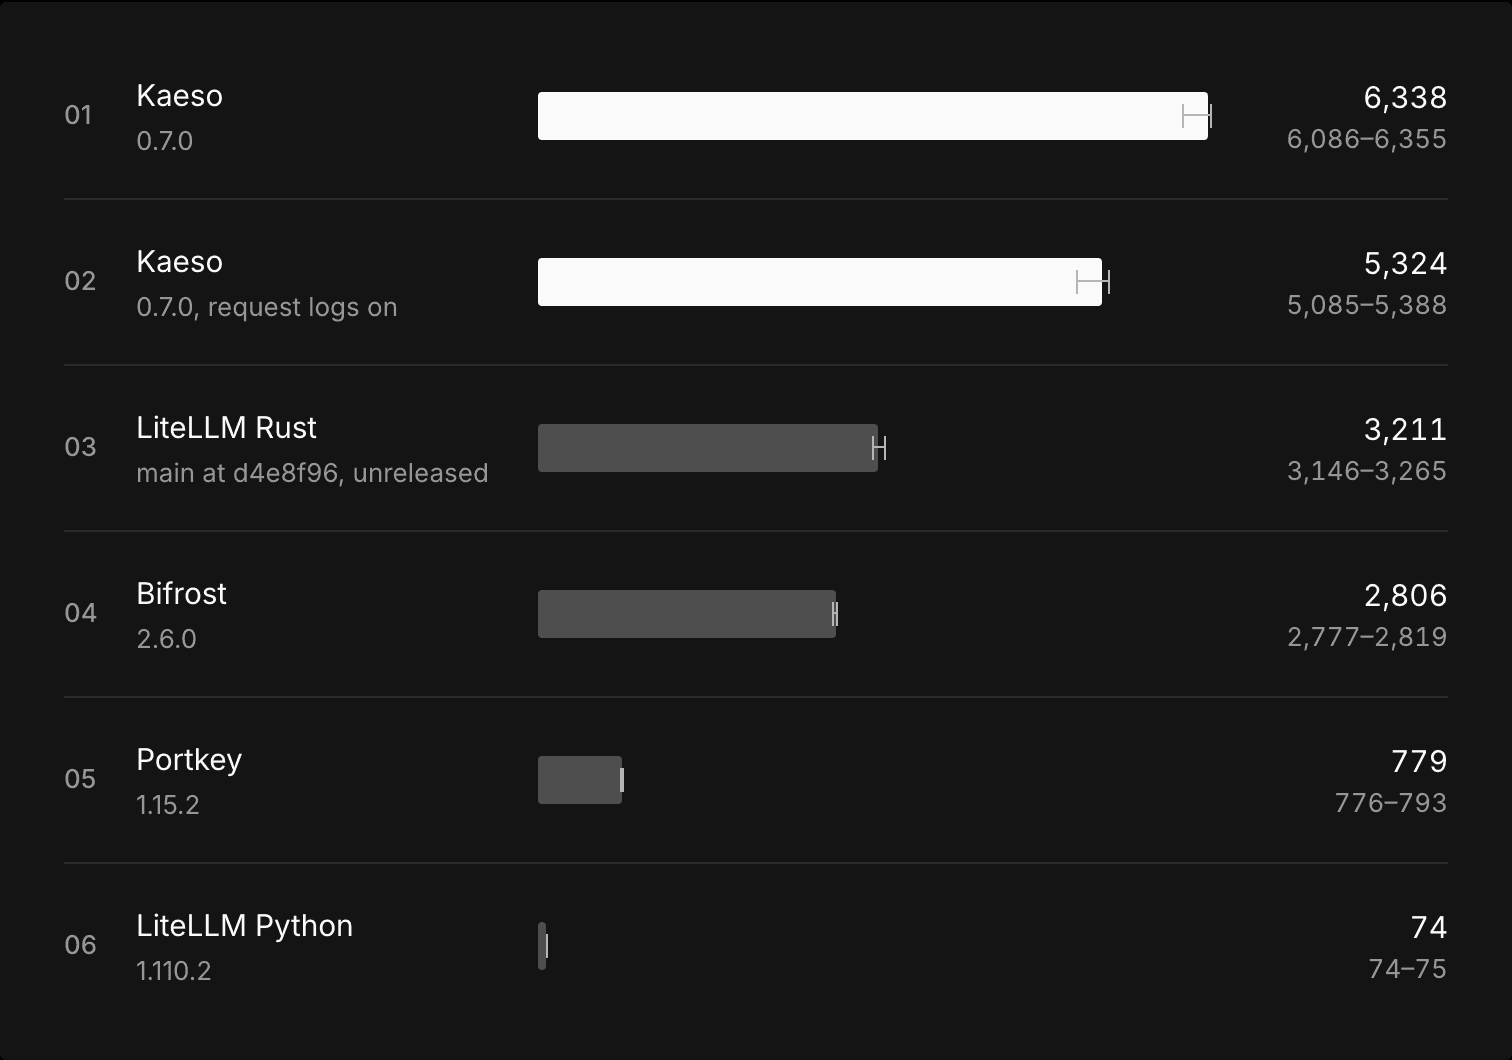
Die Zahlen
Jedes Gateway hatte dieselben zwei dedizierten Kerne. Der Kapazitätslauf schickt 64 Clients gegen einen Mock, der sofort antwortet, sodass das Gateway selbst die Grenze ist. Die Latenzmessung nutzt den Standard-Mock des Benchmarks, der wie ein schneller Anbieter in etwa 22 ms antwortet. Jede Zahl ist der Median aus drei Runden:
- Kaeso 0.7.0
- Anfragen pro Sekunde
- 6.338
- Zusätzlich p50 / p99 bei 16 Clients
- +0,54 / +1,47 ms
- CPU pro Anfrage
- 314 µs
- Kaeso 0.7.0, Request-Logs an
- Anfragen pro Sekunde
- 5.324
- Zusätzlich p50 / p99 bei 16 Clients
- +0,62 / +1,45 ms
- CPU pro Anfrage
- 373 µs
- LiteLLM Rust, unveröffentlichtes
main- Anfragen pro Sekunde
- 3.211
- Zusätzlich p50 / p99 bei 16 Clients
- +0,69 / +2,26 ms
- CPU pro Anfrage
- 573 µs
- Bifrost 2.6.0
- Anfragen pro Sekunde
- 2.806
- Zusätzlich p50 / p99 bei 16 Clients
- +0,71 / +4,08 ms
- CPU pro Anfrage
- 708 µs
- Portkey 1.15.2
- Anfragen pro Sekunde
- 779
- Zusätzlich p50 / p99 bei 16 Clients
- +3,13 / +20,40 ms
- CPU pro Anfrage
- 1.449 µs
- LiteLLM Python 1.110.2
- Anfragen pro Sekunde
- 74
- Zusätzlich p50 / p99 bei 16 Clients
- +188 / +216 ms
- CPU pro Anfrage
- 13.563 µs
Streams kommen an, wie sie gesendet wurden. Der Abstand zwischen Chunks lag bei Kaeso im 99. Perzentil bei 7,8 ms, direkt zum Mock bei 7,5 ms; bei LiteLLM Rust bei 40,4 ms. Jede gestreamte Claude-Code- und Codex-Sitzung lieferte durch jedes Gateway gültige Tool-Aufrufe, und in keinem Lauf eines Gateways schlug eine Anfrage fehl.
Wo LiteLLM vorn liegt
Ein Benchmark, den ein Anbieter misst, sollte sagen, wo der Anbieter verliert. Hier hat Kaeso verloren:
- Speicher. LiteLLM Rust kam nie über 86 MB und braucht keine Datenbank. Kaeso erreichte 164 MB, und seine PostgreSQL und Valkey belegten weitere 271 MB.
- Ein Client. Mit einer Anfrage zur Zeit lag das p99 von LiteLLM Rust bei +0,98 ms, das von Kaeso bei +1,66 ms, und keine Runde von Kaeso kam näher.
- Gleichstand. Die Zeit bis zum ersten Token (+0,87 gegen +0,96 ms) und die abgespielte Claude-Code-Sitzung (+41,5 gegen +41,0 ms) liegen in der Spanne des jeweils anderen.
- Request-Logs kosten. Mit jeder Anfrage in ClickHouse schaffte Kaeso 16 % weniger Anfragen pro Sekunde.
Kaeso tat bei jeder Anfrage mehr
Jedes Gateway lief so, wie sein Projekt es ausliefert. Kaeso prüfte den API-Schlüssel eines Projekts und die Modelle, die das Projekt erlaubt, und speicherte die Nutzung in PostgreSQL. Beide LiteLLMs verglichen einen festen Master-Schlüssel, Bifrost und Portkey prüften gar keinen. Keines der anderen speicherte etwas. Dass Kaeso mehr arbeitet und trotzdem mehr Anfragen schafft, ist das Ergebnis, das wir prüfen wollten.
Die Belege
Eine Zahl auf der Website eines Anbieters ist nur so gut wie das, was dahintersteht. Das steht hinter diesen:
- Der Benchmark ist ihrer. Er lief mit
BerriAI/ai-gateway-benchbei Commit44365ca, Mock-Anbieter und alle drei Treiber unverändert:load-probe,run_http_bench.pyundsession_runner.py. Unsere Skripte starten nur jedes Gateway, binden es an seine Kerne, stellen jedem Lauf einen direkten Lauf zum Mock gegenüber und wiederholen alles in Runden. - Jede Version ist festgelegt. Jedes Image lief über seinen Digest, aufgeführt auf der Benchmark-Seite. LiteLLM Rust hat noch kein Release, daher heißt es
mainbeid4e8f96. Sein Dockerfile baut bei diesem Commit nicht, also haben wir denselben Commit inrust:1.98.0kompiliert. Ein zweiter Build auf einer frischen Maschine ergab ein Binary mit demselben sha256. - Jedes Rohergebnis ist öffentlich. Das JSON jedes Laufs und das Log jedes Gateways liegen in raw.tar.gz, dazu die Skripte, die Zahlen als JSON und die Messreihe als CSV.
- Es läuft auf einer frischen Maschine erneut. Wir haben das veröffentlichte Setup auf einer neuen Maschine mit 4 vCPUs ausgeführt. Jedes Gateway lief eine Runde ohne Fehler. Die Zahlen lagen auf diesem Host niedriger (Kaeso 5.287, LiteLLM Rust 2.179 Anfragen pro Sekunde), und Kaeso lag wieder vorn.
- Die Seite kann nicht von den Daten abweichen. Die Benchmark-Seite liest ihre Zahlen aus den veröffentlichten Ergebnissen. Ein Test schlägt fehl, wenn sie abweichen oder wenn ein Satz wie „fast die doppelte Last“ für die Zahlen nicht mehr gilt.
- Es liegt zur Prüfung in ihrem Repository. Pull Request 7 (öffnet in einem neuen Tab) in
BerriAI/ai-gateway-benchfügt Kaeso als Gateway hinzu, mit den Ergebnissen dieses Laufs, damit die Maintainer ihn wiederholen können.
Wer gemessen hat
Der Autor von Kaeso hat diesen Benchmark gemessen, auf einer Maschine. BerriAI nennt seine eigenen veröffentlichten Ergebnisse Single-Host und vom Anbieter gemessen; das gilt hier genauso. Behandeln Sie die Zahlen als Behauptung, die Sie prüfen, und prüfen Sie sie. Der zweite Artikel, wie man ein AI-Gateway misst, ohne sich selbst zu täuschen, beschreibt die Fehler, die wir unterwegs gefunden haben.
Selbst messen
Auf einer frischen Ubuntu-24.04-Maschine mit vier Kernen, als root:
Drei Runden dauern etwa 90 Minuten, der Kapazitätslauf weitere 30. Absolute Zahlen ändern sich von Maschine zu Maschine; vergleichen Sie Gateways aus demselben Lauf. Jede Tabelle, die Methode und jeder Image-Digest stehen auf kaeso.app/benchmarks.
Von Devin Oldenburg (Logicplanes) (öffnet in einem neuen Tab)