Kaeso 在 LiteLLM 自己的基准测试中
我们使用 LiteLLM 背后的公司 BerriAI 发布的 ai-gateway-bench,将 Kaeso 0.7.0 与 LiteLLM、Bifrost 和 Portkey 一同测试。以下是结果,以及每个数字背后的证据。
- 发布日期
- 阅读时间
- 5 分钟
LiteLLM 背后的公司 BerriAI 发布了 ai-gateway-bench(在新标签页中打开),用来测量 AI 网关在模型服务商之上额外增加的开销。我们运行了它的本地测试,并在它所比较的每个网关旁加入了 Kaeso 0.7.0:LiteLLM Rust、LiteLLM Python、Bifrost 和 Portkey。每个网关都使用最新版本,运行在同一台机器上,基准测试自带的模拟服务商和驱动程序均未改动。
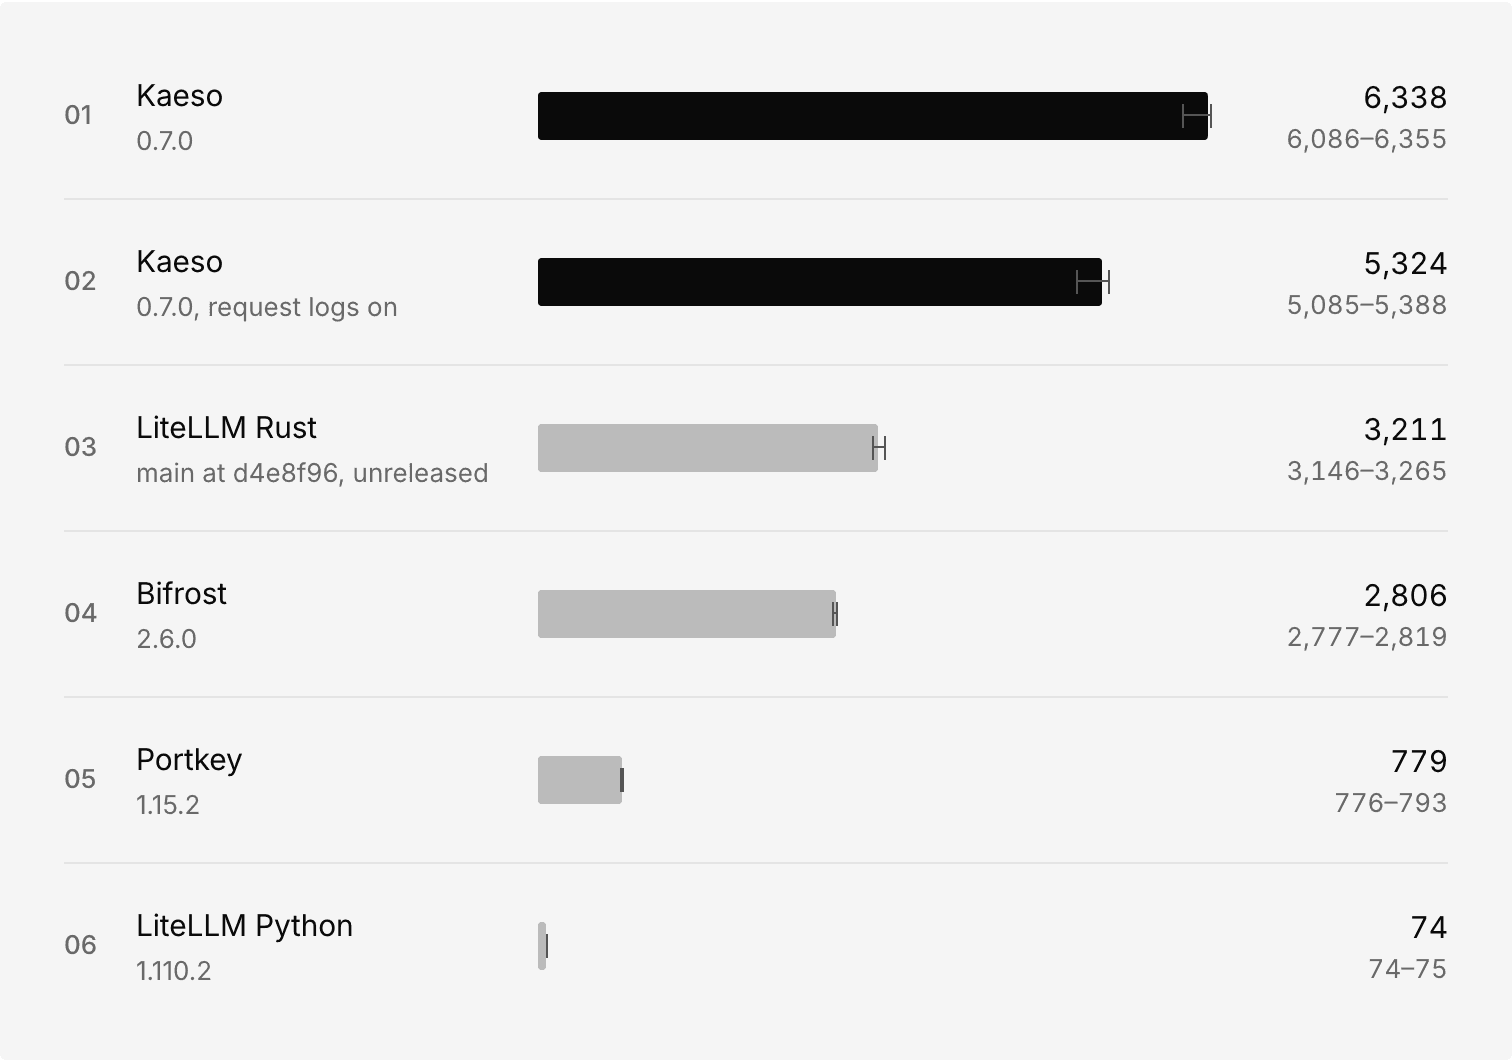
在相同的两个核心上,Kaeso 每秒处理 6,338 个请求,LiteLLM Rust 为 3,211 个。
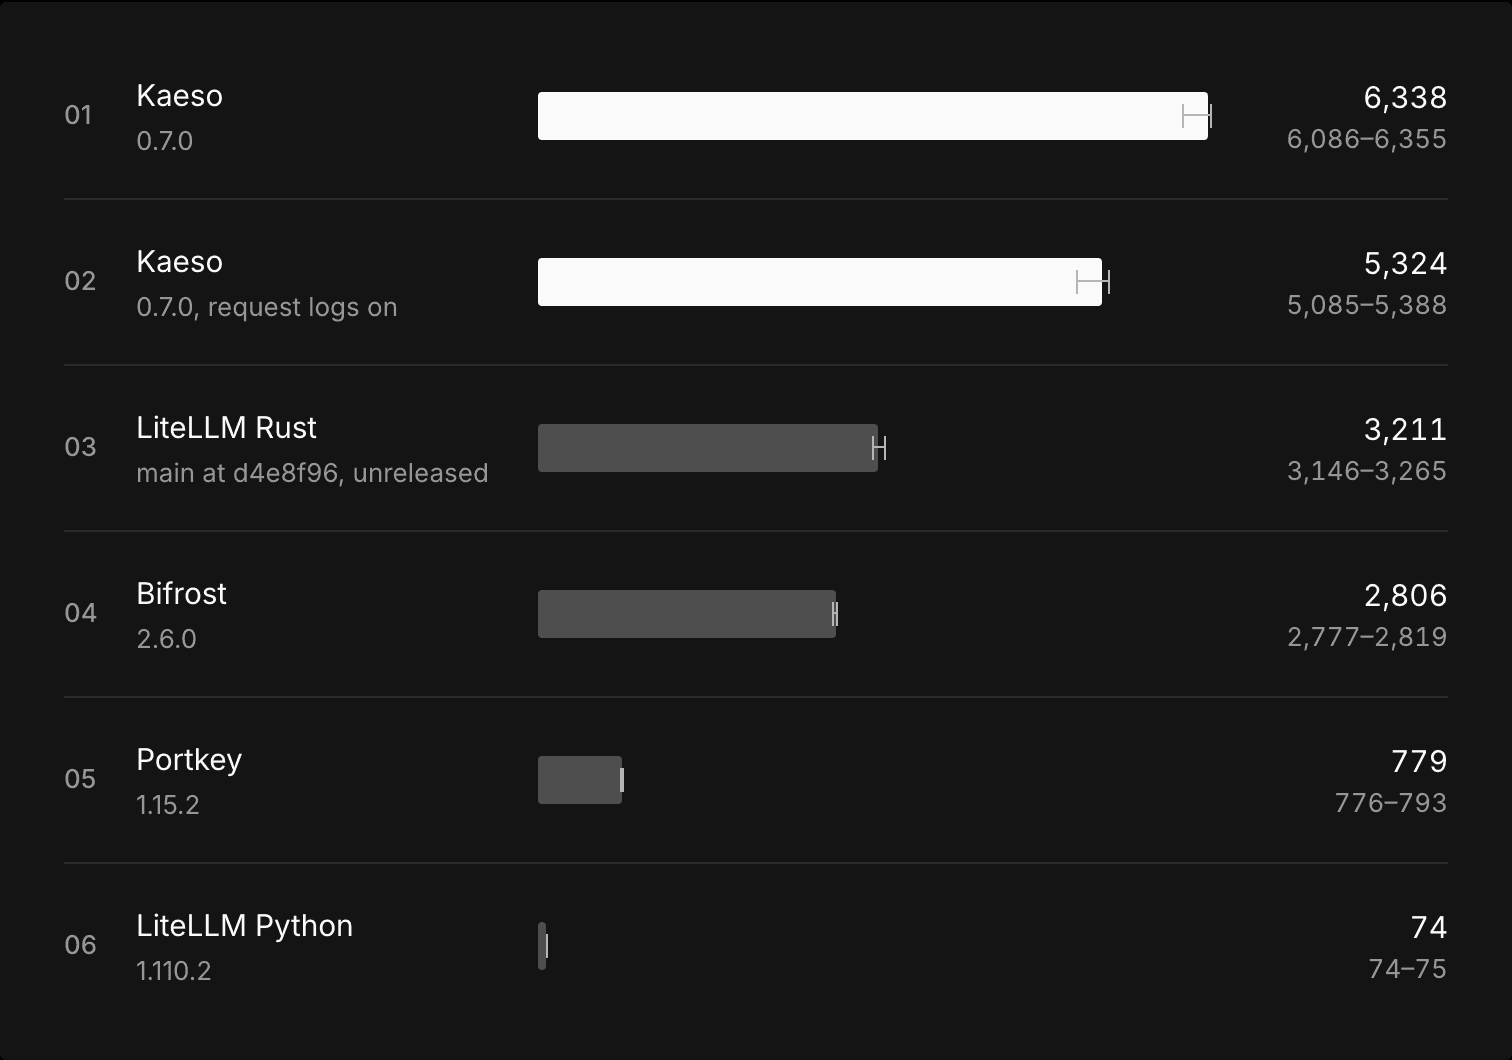
结果
每个网关都使用相同的两个专用核心。容量测试让 64 个客户端对一个立即应答的模拟服务商发起请求,因此瓶颈就是网关本身。延迟测试使用基准测试默认的模拟服务商,约 22 ms 应答,与快速的服务商相当。每个数字都是三轮的中位数:
- Kaeso 0.7.0
- 每秒请求数
- 6,338
- 16 个客户端时附加的 p50 / p99
- +0.54 / +1.47 ms
- 每个请求的 CPU
- 314 µs
- Kaeso 0.7.0,开启请求日志
- 每秒请求数
- 5,324
- 16 个客户端时附加的 p50 / p99
- +0.62 / +1.45 ms
- 每个请求的 CPU
- 373 µs
- LiteLLM Rust,未发布的
main- 每秒请求数
- 3,211
- 16 个客户端时附加的 p50 / p99
- +0.69 / +2.26 ms
- 每个请求的 CPU
- 573 µs
- Bifrost 2.6.0
- 每秒请求数
- 2,806
- 16 个客户端时附加的 p50 / p99
- +0.71 / +4.08 ms
- 每个请求的 CPU
- 708 µs
- Portkey 1.15.2
- 每秒请求数
- 779
- 16 个客户端时附加的 p50 / p99
- +3.13 / +20.40 ms
- 每个请求的 CPU
- 1,449 µs
- LiteLLM Python 1.110.2
- 每秒请求数
- 74
- 16 个客户端时附加的 p50 / p99
- +188 / +216 ms
- 每个请求的 CPU
- 13,563 µs
流式输出原样送达。Kaeso 的分块间隔 p99 为 7.8 ms,直连模拟服务商为 7.5 ms;LiteLLM Rust 为 40.4 ms。每个流式的 Claude Code 和 Codex 会话经过每个网关都给出了有效的工具调用,任何网关的任何一次运行都没有失败的请求。
LiteLLM 领先之处
由厂商自己运行的基准测试,应该说明厂商在哪里落后。Kaeso 落后的地方如下:
- **内存。**LiteLLM Rust 从未超过 86 MB,且无需数据库。Kaeso 最高达到 164 MB,其 PostgreSQL 和 Valkey 另占 271 MB。
- **单个客户端。**每次只发一个请求时,LiteLLM Rust 的 p99 为 +0.98 ms,Kaeso 为 +1.66 ms,Kaeso 没有任何一轮更接近。
- **平手。**首个 token 时间(+0.87 对 +0.96 ms)和回放的 Claude Code 会话(+41.5 对 +41.0 ms)都落在彼此的范围之内。
- **请求日志的代价。**将每个请求写入 ClickHouse 时,Kaeso 每秒处理的请求少了 16%。
Kaeso 对每个请求做得更多
每个网关都按其项目的发布方式运行。Kaeso 检查项目的 API 密钥和该项目允许的模型,并将用量记录到 PostgreSQL。两个 LiteLLM 只比对一个固定的主密钥,Bifrost 和 Portkey 完全不检查密钥。其他网关都不保存任何内容。Kaeso 做了更多工作,却仍处理了更多请求,这正是我们想要验证的结果。
证据
厂商网站上的数字,只和它背后的证据一样可信。以下是这些数字背后的证据:
- **基准测试是他们的。**测试使用
BerriAI/ai-gateway-bench的提交44365ca,其模拟服务商和三个驱动程序均未改动:load-probe、run_http_bench.py和session_runner.py。我们的脚本只负责启动每个网关、将其固定到核心上、为每次运行配对一次直连模拟服务商的运行,并分轮重复。 - **每个版本都已固定。**每个镜像都按摘要运行,摘要列在基准测试页面上。LiteLLM Rust 尚无发布版本,因此标注为
main分支的d4e8f96。该提交的 Dockerfile 无法构建,我们改用rust:1.98.0编译同一提交。在另一台全新机器上再次构建,得到的二进制文件 sha256 完全相同。 - **在全新机器上可以复现。**我们在一台新的 4 vCPU 机器上运行了公开的安装脚本。每个网关都无错误地跑完一轮。这台主机上的数字更低(Kaeso 每秒 5,287 个请求,LiteLLM Rust 2,179 个),Kaeso 依然领先。
- **页面不会与数据脱节。**基准测试页面从公开的结果中读取数字。一旦两者不一致,或“近两倍的负载”这类说法不再符合数字,测试就会失败。
- 已提交到他们的仓库供审阅。
BerriAI/ai-gateway-bench中的第 7 号拉取请求(在新标签页中打开)将 Kaeso 添加为网关,并附上这次运行的结果,方便其维护者复测。
谁做的测试
这次基准测试由 Kaeso 的作者在一台机器上完成。BerriAI 称其自己公布的结果为单机且由厂商测试,这里同样如此。请把这些数字当作需要验证的说法,并亲自验证。第二篇文章《如何测试 AI 网关而不自欺欺人》介绍了我们在过程中发现的错误。
自己运行
在一台全新的四核 Ubuntu 24.04 机器上,以 root 身份运行:
三轮约需 90 分钟,容量测试另需 30 分钟。绝对数值因机器而异,请比较同一次运行中测得的网关。所有表格、测试方法和每个镜像摘要都在 kaeso.app/benchmarks 上。